Noticias DeepSeek
DeepInfer: DeepSeek abre el motor que ejecuta su IA
DeepSeek publicó el 20 de octubre DeepInfer, el motor de inferencia que utiliza para servir DeepSeek-V4.1-Flash a gran escala. El código está disponible bajo licencia Apache 2.0 en su repositorio oficial. La empresa también publicó benchmarks y detalles de su despliegue.
Hay una pregunta interesante detrás del anuncio: ¿cuánto ayuda abrir el motor si ejecutarlo con eficiencia sigue requiriendo infraestructura considerable? Para responderla, conviene mirar tanto el código que puedes descargar como las condiciones que acompañan a los números.
¿Qué es DeepInfer y para qué sirve?
La inferencia es el proceso con el que un modelo ya entrenado genera una respuesta. DeepInfer organiza ese trabajo: reparte cálculos, coordina solicitudes y utiliza kernels optimizados, pequeñas rutinas que aprovechan el hardware. Su objetivo es atender más solicitudes manteniendo baja la espera del usuario.
Según el README de esta versión, el modelo compatible es DeepSeek-V4.1-Flash, con soporte para GPU NVIDIA SM100 y NPU Huawei Ascend 950. El lanzamiento permite estudiar y adaptar el motor que lo ejecuta; las capacidades del modelo y el rendimiento del servicio son preguntas diferentes.
¿Qué incluye el código abierto de DeepInfer?
La publicación entrega el núcleo de ejecución y ejemplos de inferencia offline. El propio README identifica las piezas adicionales necesarias para construir un servicio completo:
| Área | Estado de esta publicación |
|---|---|
| Motor, kernels y ejecución distribuida | Incluidos |
| DSpark, planificación asíncrona y salidas estructuradas | Incluidos |
| Sistema de caché KV | Requiere implementación adicional |
| Separación de visión, prefill y decode | Requiere integración; buena parte del soporte del motor ya existe |
| Balanceo entre réplicas | Requiere implementación adicional |
La caché KV reutiliza cálculos de contexto anteriores; el balanceador reparte solicitudes. Son piezas importantes cuando muchas personas usan el servicio a la vez. Por eso, tener el motor disponible no equivale a descargar una réplica completa del servicio de DeepSeek.
Benchmarks de DeepInfer: qué muestran las cifras
DeepSeek publica pruebas de procesamiento del contexto inicial (prefill) con 4 GPU SM100 y de generación de la respuesta (decode) con 64 GPU SM100. Cada prueba usa un único dominio de interconexión de alta velocidad, según su metodología y script de reproducción.
Este es su gráfico original de generación. El eje horizontal representa velocidad por usuario; el vertical, rendimiento agregado por GPU. Las etiquetas de los puntos indican solicitudes por rank de paralelismo de datos.
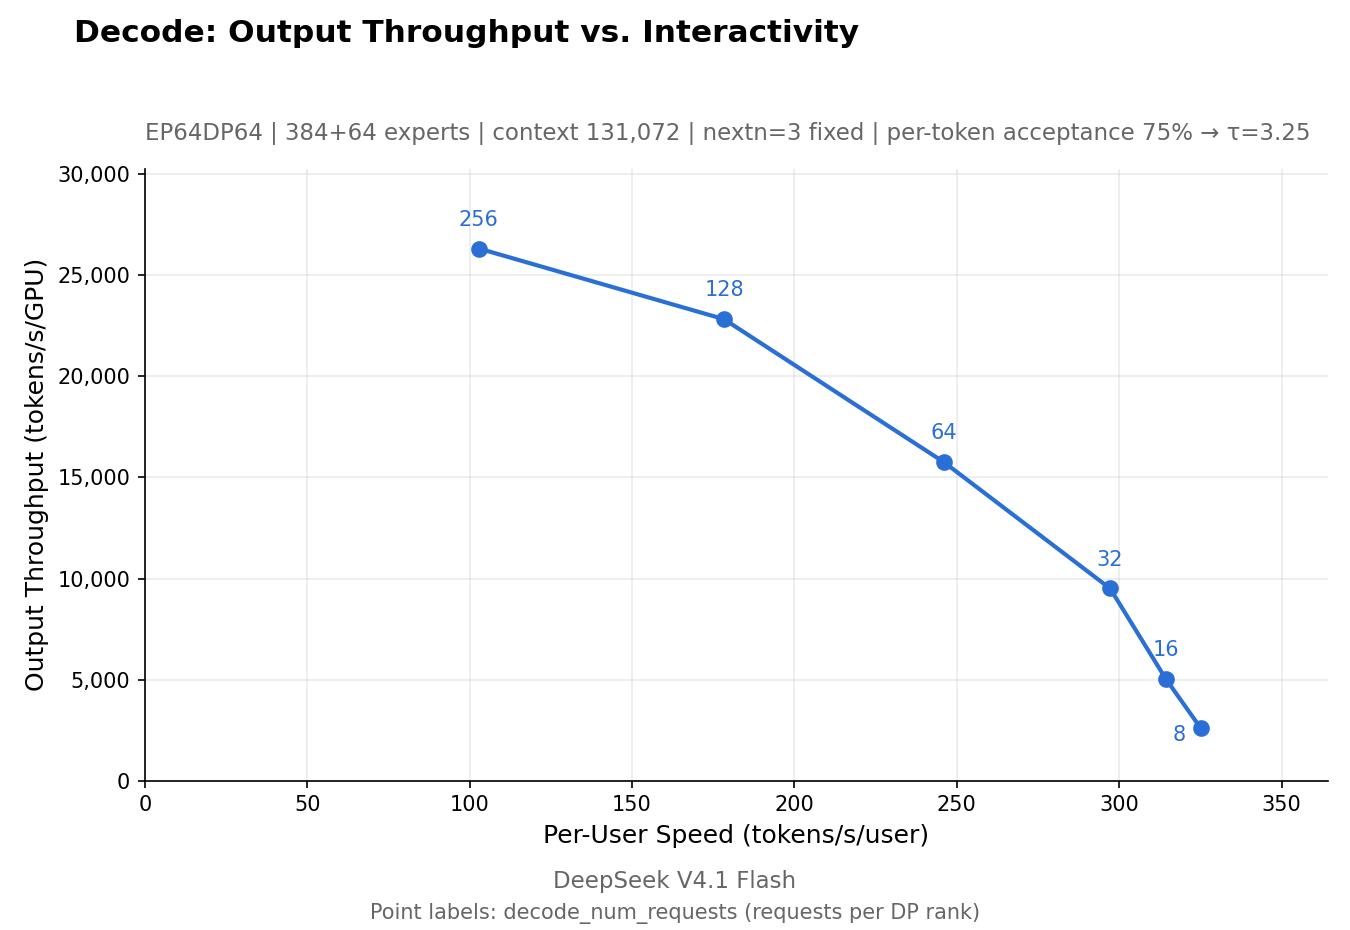
Abrir el gráfico a tamaño completo. La curva muestra una decisión práctica: atender más trabajo simultáneo puede aumentar el total generado por GPU mientras cada usuario recibe tokens más despacio. Un número de rendimiento aislado no describe toda la experiencia.
Prueba a cambiar la carga de DSpark
DSpark genera tokens candidatos y después los verifica. DeepSeek compara verificar siempre cinco candidatos con elegir una cantidad dinámica. Su Q&A técnico publica las siguientes estimaciones de rendimiento a partir de datos EP64/DP64. Son un experimento distinto del gráfico anterior.
Toca una concurrencia. Con 16 secuencias por rank, la variante dinámica pierde ligeramente; con 96, gana un 11 %. Cerca del punto operativo que describe la empresa, unas 60 secuencias por rank, la tabla estima +5,4 %. La carga importa.
La carga cambia el resultado
Tokens generados por segundo y por rank · estimaciones de DeepSeek
Concurrencia · secuencias por rank
13.730 → 14.466 tokens/s/rank al pasar de verificación fija a dinámica.
| Sec./rank | Fija (5) | Dinámica | Cambio |
|---|---|---|---|
| 16 | 4891 | 4816 | -1,5% |
| 32 | 8964 | 9111 | +1,6% |
| 48 | 12.032 | 12.467 | +3,6% |
| 60 | 13.730 | 14.466 | +5,4% |
| 72 | 14.962 | 15.961 | +6,7% |
| 96 | 16.817 | 18.660 | +11,0% |
¿Qué hardware necesitas para usar DeepInfer?
El repositorio pide Linux, GCC 13 o superior y Python 3.12, además de CUDA 13 para NVIDIA o CANN 9.2 para Ascend. Es una publicación dirigida a equipos que operan infraestructura de IA.
En su Q&A, DeepSeek recomienda 64 GPU para prefill y otras 64 para decode como la unidad más pequeña que considera eficiente en ese diseño de producción. Son 128 GPU en total. La recomendación describe eficiencia a escala: no establece un mínimo universal para arrancar cualquier ejemplo.
Si solo utilizas un chatbot o una herramienta creativa, este lanzamiento te ayuda a entender cómo se sirve el modelo. Para aprovechar directamente el código hace falta un equipo capaz de integrar y operar esa infraestructura.
¿Es gratis? ¿Bajará el precio de la API?
La licencia Apache 2.0 permite usar y modificar el código bajo sus términos. Ejecutarlo sigue teniendo costos de hardware, energía y operación. El anuncio expresa la intención de reducir el costo de cómputo y el consumo energético; no comunica una nueva tarifa de API que podamos aplicar a tu factura.
El aporte inmediato es acceso al motor, a decisiones de arquitectura y a resultados que otros equipos pueden intentar reproducir. Una reducción de precio para el usuario dependerá de cómo se use ese trabajo y de las tarifas que publique cada proveedor.
El anuncio original de DeepSeek
DeepSeek · publicación original del 20 de octubre de 2026
Introducing DeepInfer, our in-house inference framework, now fully open source!
DeepSeek presenta el motor que utiliza con V4.1-Flash y enlaza el código. El README detalla el alcance de esta versión y las piezas pendientes de integración.
¿Deberían OpenAI y Anthropic abrir también sus motores de producción? Hay algo concreto que discutir: cuánto valor aporta poder inspeccionar y adaptar el software, y cuánto de ese valor llega a quienes no pueden operar un clúster.
Revisión editorial: 20 de octubre de 2026. Fuentes técnicas fijadas al commit 774ce244b87cc0eb8d4b94ab9f5de2ab22049f01. Benchmarks y estimaciones atribuidos a DeepSeek; no ejecutamos pruebas propias. Portada: composición editorial de HeyMark con el avatar oficial de DeepSeek en GitHub. Gráfico interior: original del repositorio.Fuente
Planifica el próximo post en HeyMark.
Guarda la idea, revisa el texto con tu equipo y mira cómo le fue después en las cuentas que conectaste.