Noticias Kimi
Kimi K3.1 Pro supera a Claude Opus 5.5 en SWE Marathon
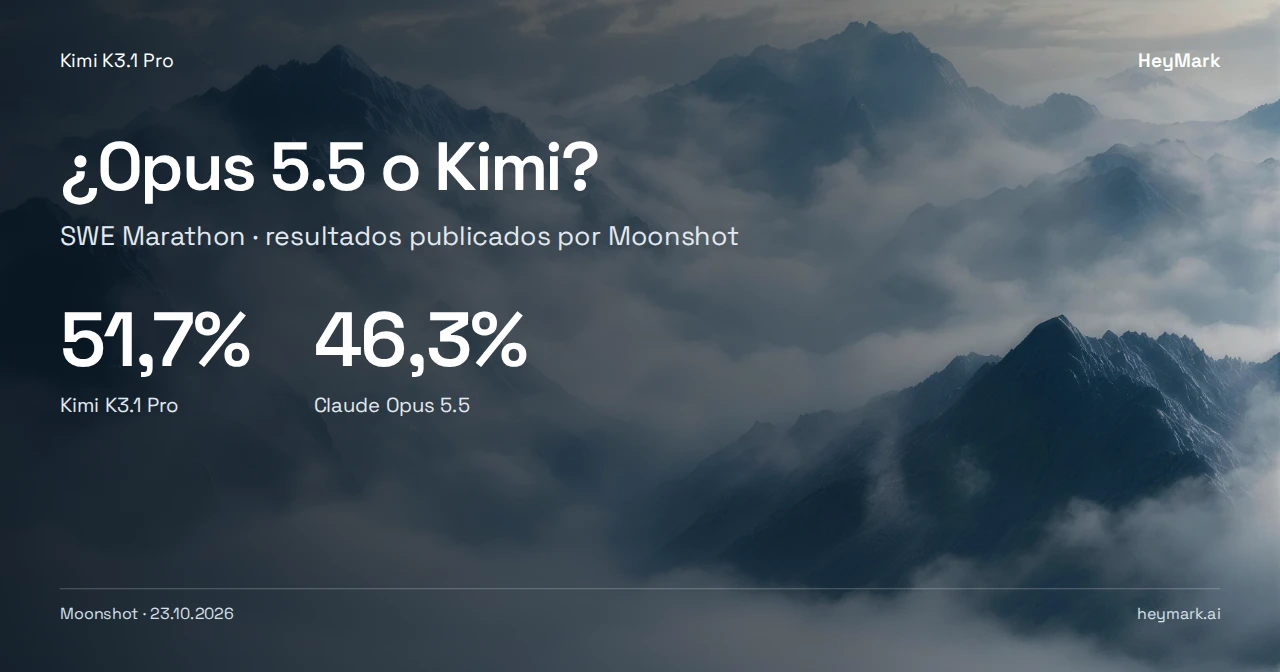
Portada: adaptación editorial de HeyMark con el fondo y la identidad visual del lanzamiento oficial de Kimi. Datos de Moonshot · SWE Marathon.
Kimi K3.1 Pro consiguió un 51,7% en SWE Marathon, por delante del 46,3% de Claude Opus 5.5, según la tabla que Moonshot publicó en el lanzamiento del 23 de octubre. Son resultados recopilados por el proveedor: la tabla evalúa Kimi con Claude Code y recoge cifras publicadas de sus rivales. El modelo ya está disponible en los productos de Kimi y en su API.
Si estás mirando alternativas a Claude o GPT para programar, ese resultado merece atención. La pregunta útil es cuánto de esa ventaja se mantiene en tu trabajo y qué pagas por conseguirla. Comparamos las pruebas publicadas, dos demos oficiales y el costo API.
¿En qué supera a Claude y dónde sigue por detrás?
Otra evaluación, esta vez de Artificial Analysis, sitúa a Kimi en 67% en Terminal-Bench 4.0, frente al 64% de Claude Sonnet 5.5 y al 13% de Kimi K3. Esta prueba pone a los agentes a resolver tareas en una terminal. Es un resultado independiente distinto del SWE Marathon del titular.
Al ampliar la mirada, el orden cambia. Kimi alcanza 55 puntos y el cuarto puesto del Intelligence Index. Claude Opus 5.5 obtiene 58; Sonnet 5.5 y Muse Wonder Full, 56. El informe identifica las configuraciones de razonamiento y el uso de fallback en los Claude. Resultados y condiciones.
La tabla oficial reúne 14 pruebas. Este resumen calcula la posición media de cada modelo y la expresa en un índice de 0 a 100. Puedes cambiar entre los cuatro modelos con datos en las 14 pruebas o los seis modelos en las nueve pruebas que comparten. Cada vista usa la misma selección para todos sus participantes.
Promedio de posiciones
Índice HeyMark · /100Calculado sobre la tabla de Moonshot. Más alto indica mejores posiciones dentro del grupo.
Fable y GLM tienen datos ausentes; puedes incluirlos en la vista de nueve pruebas comunes.
El índice resume posiciones; no mide el tamaño de la ventaja ni es una tasa de acierto. Las dos vistas usan grupos distintos y no se comparan entre sí.
Ver los 14 benchmarks y todos sus resultados
Tabla con desplazamiento horizontal y vertical · — sin resultado publicado
| Prueba · unidad | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 | DeepSeek V4.1 Flash 1017 | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0% | 65,7 | 66,4 | 58,2 | 57,9 | 42,3 | 41,8 |
| SWE Marathon% | 51,7 | 46,3 | 42,5 | 45,6 | 40 | 42,5 |
| Terminal-Bench-Science 0.1% | 38,1 | 63,3 | 68,1 | 40 | 15,7 | 8,1 |
| Kimi Code Bench 3.0 Long-horizon% | 61,2 | 58,5 | 66,5 | 58,8 | 51,5 | 45,5 |
| Agents’ Last Exam% | 43,2 | 42,6 | 41,8 | — | 37,7 | 26,2 |
| BenchCAD w/ tools% | 92,7 | 96,2 | 95,9 | 92,6 | 81,6 | — |
| OfficeQA Pro v2% | 64,4 | 62,2 | 54,4 | 54,5 | 40,4 | 31,1 |
| Frontier Finance% | 58,6 | 56,7 | 45 | 60,8 | 54,5 | 57,5 |
| GDPval-AA v2.1Elo | 1846 | 1866 | 1573 | 1754 | 1746 | 1650 |
| OSWorld V2.1% | 79,6 | 81,8 | 75,8 | 80,7 | 69,3 | — |
| Humanity’s Last Exam Full w/ tools% | 70 | 67,7 | 57,2 | 65,6 | 58,8 | 62,5 |
| GDP.pdf% | 34,6 | 30,6 | 34,2 | 27,6 | 17,2 | 11,2 |
| ChartoGraphy w/ tools% | 90,2 | 89 | 91 | 88,4 | 83 | — |
| ZeroBench_main w/ tools (pass@5)% | 63 | 61 | 58 | 59 | 51 | — |
Cómo calculamos el resumen y qué incluye
Índice editorial de posición, calculado por HeyMark: en cada prueba ordenamos los modelos de mayor a menor resultado. Los empates comparten la posición media. Promediamos esas posiciones con el mismo peso por prueba y las convertimos a una escala de 0 a 100: 100 sería primero en todas; 0, último en todas. No mide el tamaño de la ventaja ni es una puntuación de precisión o un benchmark independiente. Cambiar el grupo cambia el índice; ambas vistas no se comparan entre sí.
Fórmula: índice = 100 × (N − posición media) / (N − 1), donde N es el número de modelos del grupo.
Las 14 pruebas incluyen resultados recopilados por Moonshot de distintos entornos, informes y evaluadores. La vista de seis modelos incluye Terminal-Bench, SWE Marathon, Terminal-Bench-Science, Kimi Code Bench, OfficeQA, Frontier Finance, GDPval-AA, HLE y GDP.pdf. El resultado independiente del 67% de Artificial Analysis queda fuera para evitar contar dos veces Terminal-Bench.
Terminal-Bench 4.0: Kimi: Claude Code, esfuerzo max. Rivales: mejor cifra entre anuncios y leaderboard.
SWE Marathon: Kimi y DeepSeek usan Claude Code; los demás resultados proceden del leaderboard SWE-Marathon.
Terminal-Bench-Science 0.1: Kimi usa Claude Code. Moonshot publica para DeepSeek el 15,7% del leaderboard, obtenido con una versión Flash anterior.
Kimi Code Bench 3.0 Long-horizon: Prueba interna de Moonshot. Esfuerzo máximo; los Claude pueden incluir fallback.
Agents’ Last Exam: 122 tareas. DeepSeek usa Claude Code; Kimi usa Kimi Code. Otras cifras del sitio del benchmark.
BenchCAD w/ tools: Voxel IoU: coincidencia geométrica. Kimi se evalúa en un subconjunto de 1.000 archivos; rivales según sus informes.
OfficeQA Pro v2: Astra usa Codex; los demás, Claude Code. Corpus de PDF renderizados como imágenes y control de búsquedas de respuestas.
Frontier Finance: Entorno oficial finance agent v2.
GDPval-AA v2.1: Resultados de Artificial Analysis citados en la tabla de Moonshot. Escala Elo.
OSWorld V2.1: Kimi usa su Agent harness; la cifra de Astra se toma del informe técnico de Muse Wonder.
Humanity’s Last Exam Full w/ tools: HLE Full con herramientas, según la figura de Moonshot. No equivale al 52% de la evaluación independiente de AA.
GDP.pdf: Con Python, promedio de cinco ejecuciones; protocolo de la tabla de Moonshot.
ChartoGraphy w/ tools: Con Python, promedio de cinco ejecuciones; protocolo de la tabla de Moonshot.
ZeroBench_main w/ tools (pass@5): Con Python, promedio de cinco ejecuciones; métrica pass@5.
Cálculo de HeyMark sobre resultados publicados por Moonshot el 23.10.2026. Esfuerzo máximo; Claude puede incluir fallback y GPT, protecciones de ciberseguridad.
¿Por qué aparecen un 67% y un 65,7% para Kimi? Proceden de evaluaciones distintas. El primero es de Artificial Analysis; el segundo está en la tabla de Moonshot, que evalúa Kimi con Claude Code y recoge resultados publicados de los rivales. Mezclarlos en una misma clasificación borraría esas condiciones. Método de Moonshot.
Para decidir si cambiar de modelo, este es un buen punto de partida: comparar una tarea que ya conozcas, comprobar el resultado y registrar el costo completo, incluidas las correcciones. Una tarifa menor por token puede acabar en una cuenta mayor si el agente necesita más intentos.
Dos demos oficiales que puedes mirar de cerca
Moonshot publicó ejemplos de trabajo con herramientas 3D. Los videos siguientes son demostraciones seleccionadas por la empresa. La creación incluye software, bibliotecas y recursos externos; aquí puedes ver el resultado sin atribuir cada elemento visual al modelo.
Un aeropuerto construido en Blender
La primera demo muestra un jardín interior de aeropuerto. Moonshot identifica Blender, Python, Geometry Nodes y Cycles entre las herramientas. Acredita el cielo HDRI de Poly Haven a Greg Zaal y Jarod Guest, bajo CC0.
Abrir la demo oficial del aeropuerto.
Un motor con piezas que se separan
La segunda usa FreeCAD y Python. El despiece permite observar cómo se organiza la geometría del motor. Es un ejemplo de modelado; la animación por sí sola no acredita que el diseño funcione como motor real.
Abrir la demo oficial del motor.
Puedes consultar ambos ejemplos, sus descripciones y otros proyectos en el anuncio técnico original.
¿Qué es 3D Make?
Kimi también presenta 3D Make en su web y app: permite previsualizar y editar modelos, descargarlos para impresión 3D o exportar videos y Live Photos. La siguiente imagen pertenece a esa herramienta. Funciones anunciadas.
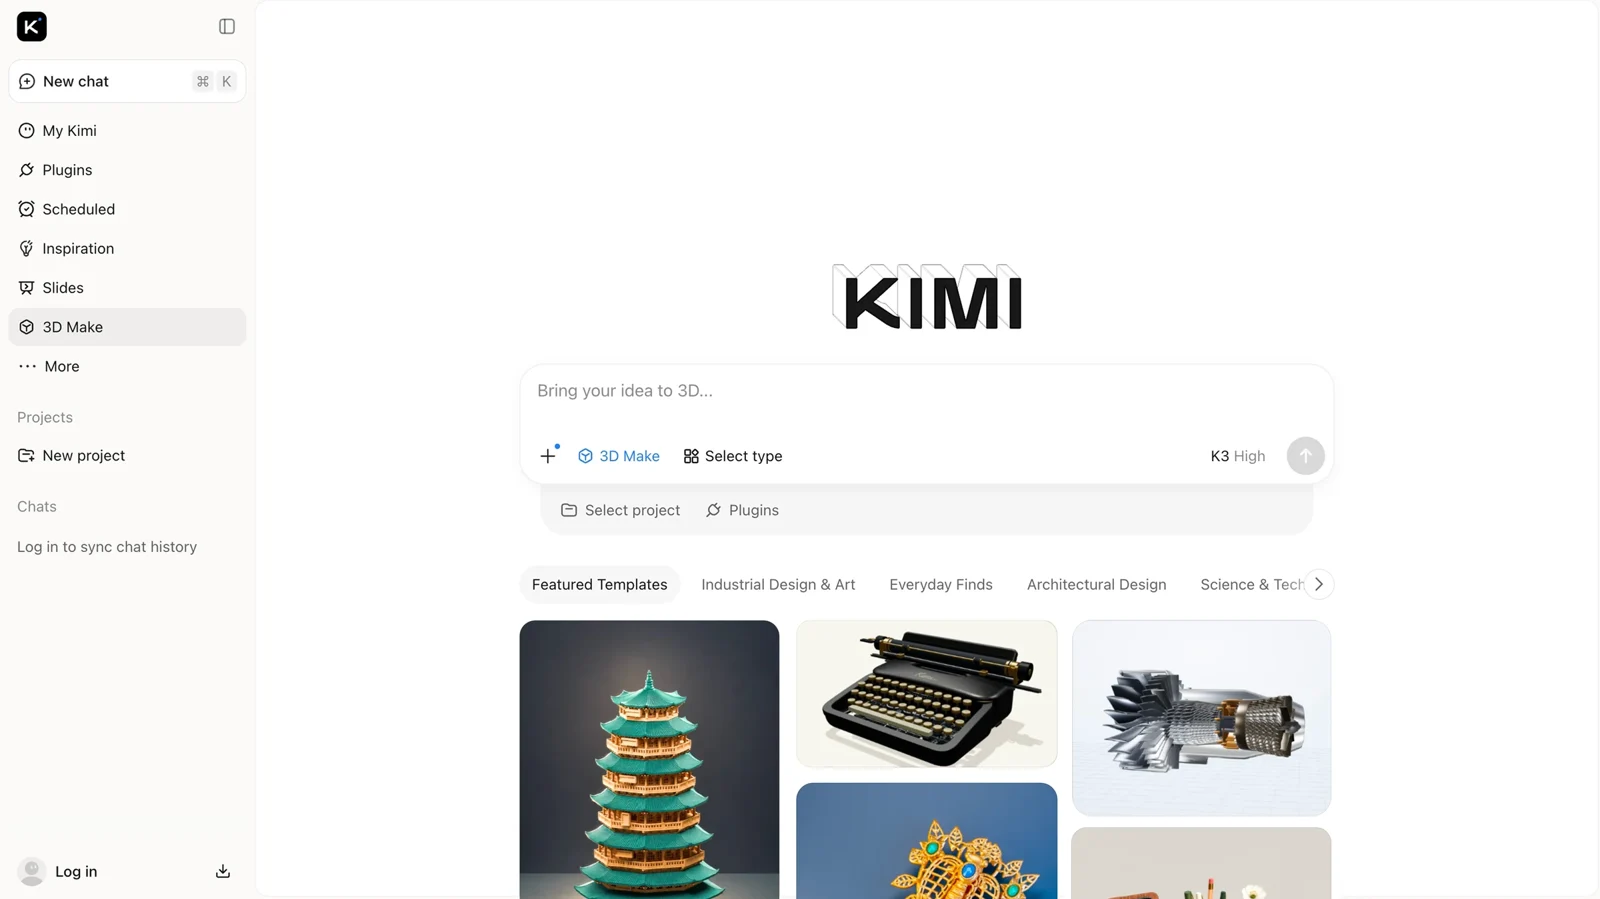
Para un creador, conviene distinguir el archivo 3D que podrás editar de un video que solo muestra su aspecto. Antes de usarlo en una pieza, revisa geometría, materiales, derechos de los recursos y el formato que acepta tu editor. Una previsualización bonita no permite comprobar todo eso.
Precio de Kimi K3.1 Pro y Highspeed
La tabla recoge las tarifas API que comprobamos el 26 de octubre. La lectura de caché tiene una tarifa propia; las escrituras dependen de cuánto tiempo se conserva. La suscripción de Kimi se cobra por separado. Documentación de facturación.
| Modelo | Entrada | Salida | Lectura caché | Escritura 5 min | Escritura 1 h |
|---|---|---|---|---|---|
| K3.1 Pro | $2 | $10 | $0,20 | $2 | $4 |
| K3.1 Pro Highspeed | $4 | $20 | $0,20 | $4 | $8 |
Tarifas oficiales ↗ · 26.10.2026
¿Cuánto cuesta una solicitud?
Lo que envías consume entrada; la respuesta consume salida. Ajusta las cantidades para ver el costo de ambas versiones.
Introduce cantidades enteras desde 0, con un máximo combinado de 1.048.576 tokens.
- K3.1 Pro
- USD 0.04
- K3.1 Pro Highspeed
- USD 0.08
Ejemplo calculado, sin caché ni herramientas. Los tokens son cantidades declaradas, no el conteo de un texto de prueba. La escritura de caché y otros servicios pueden añadir cargos.
Moonshot anuncia Highspeed como una variante entre 2 y 3 veces más rápida. Esa es una afirmación del proveedor; el tiempo de tu encargo también depende de las herramientas y del trabajo que el agente termine haciendo. Anuncio.
Dónde usarlo y cuándo llegan los pesos
| Canal | Qué puedes usar | Condición |
|---|---|---|
| Web y app de Kimi | K3.1 Pro y 3D Make, según el lanzamiento. | Revisa los límites de tu cuenta y los beneficios de cada plan. |
| Kimi Work y Kimi Code | Trabajo con archivos y programación. | Work requiere la versión 3.1.0 o posterior; Code permite elegir el modelo. |
| API | kimi-k3.1-pro y kimi-k3.1-pro-highspeed. |
La guía exige una recarga exitosa mínima de US$1 para desbloquear este modelo. |
| Pesos del modelo | Publicación prometida como máximo el 4 de noviembre de 2026. | La publicación seguía pendiente en las fuentes revisadas. |
Fuentes: disponibilidad del lanzamiento, requisitos de API y planes de Kimi. La página de planes incluye Highspeed en Pro, Max y Ultra; revisa la modalidad mensual o anual antes de comparar precios.
La API admite esfuerzos de razonamiento low, high y max, con max como valor por defecto. No hay una curva pública completa por esfuerzo en las fuentes que utilizamos, así que estos resultados no permiten estimar qué ocurre al bajar a low. Guía del modelo.
El anuncio original
Anuncio de Kimi.ai en X · 23 de octubre de 2026. Moonshot presenta K3.1 Pro y Highspeed y fija el 4 de noviembre como fecha límite anunciada para publicar los pesos.
Fuente
Planifica el próximo post en HeyMark.
Guarda la idea, revisa el texto con tu equipo y mira cómo le fue después en las cuentas que conectaste.