Noticias Teorías
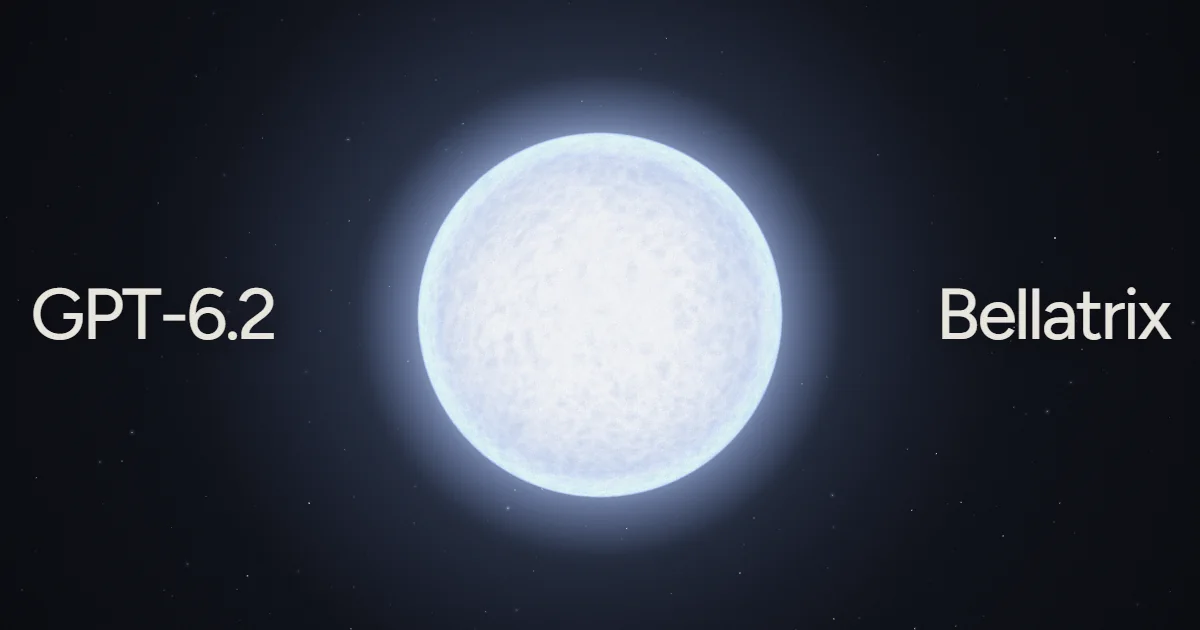
Presentando dos teorías: GPT-6.2 Bel
Bienvenido al lanzamiento que X está imaginando. La portada es nuestra sátira de lanzamiento; el artículo investiga las pistas. Al corte de esta revisión, el 4 de noviembre de 2026, GPT-6.2 Betelgeuse sigue sin anuncio oficial localizado en el catálogo y el changelog de OpenAI.
El nombre circula como “Bel”, una captura dice gpt-6.2-betelgeuse, Tibo escribe “Le GPT Fat” y aparecen dos IDs no anunciados en la API. Es comprensible que quieras unirlo todo. La parte interesante es comprobar qué eslabones tienen respaldo y dónde empieza la interpretación.
Hay un dato reciente que sí merece mirar despacio: OpenAI mostró un modelo interno sin nombre con mejor puntuación que Astra en una prueba de ingeniería. Ese dato puede alimentar una teoría. Identificar el modelo requiere evidencia adicional.
El benchmark real detrás de las teorías
En BenchCAD 2.0, OpenAI publica 0,875 para el modelo interno y 0,594 para GPT-6 Astra, este último con su máximo razonamiento. La prueba combina reconstrucción de piezas y ensamblajes 3D con conexiones de placas electrónicas. La fuente mantiene al modelo interno sin identificar.
BenchCAD 2.0 · OpenAI · 3 nov 2026
Astra frente al modelo interno
9 valores publicados · 100 casos por punto · harnesses diferentes.
- GPT-6 Astra nivel máximo de razonamiento
- Modelo interno sin nombre
Puntaje medio en BenchCAD 2.0 (0 a 1) · mayor es mejor
Proxy de costo, escala log · 1× = Astra al máximo
Toca o enfoca un punto para leerlo.
Diferencia exacta entre las dos cifras citadas
- Diferencia absoluta
- +0,281
- Cambio relativo
- +47,3 %
0,875 − 0,594. Equivale a 28,1 puntos sobre 100 en esta escala de 0 a 1.
0,281 ÷ 0,594. Es aritmética sobre el promedio de una sola prueba: no significa «47 % mejor en todo».
El proxy aplica las tarifas de Astra al modelo interno; no mide compute ni revela su precio comercial. Los harnesses de evaluación son diferentes. No se ha identificado como GPT-6.2.
Ver los 9 valoresPuntaje y proxy relativo
| Punto | BenchCAD 2.0 | Proxy de costo |
|---|---|---|
| GPT-6 Astra | ||
| 1 de 5 | 0,135 | 0,04× |
| 2 de 5 | 0,309 | 0,247× |
| 3 de 5 | 0,406 | 0,462× |
| 4 de 5 | 0,449 | 0,604× |
| 5 de 5 | 0,594 | 1× |
| Modelo interno sin nombre | ||
| 1 de 4 | 0,758 | 0,977× |
| 2 de 4 | 0,831 | 2,054× |
| 3 de 4 | 0,854 | 3,086× |
| 4 de 4 | 0,875 | 3,376× |
- El modelo interno no tiene nombre público. OpenAI no lo ha identificado como GPT-6.2, «Betelgeuse» ni «Bel».
- No incluimos Claude ni otros modelos: no hay resultados comparables publicados en BenchCAD 2.0.
- El 95,9 % de Astra en BenchCAD (v1) es otra versión de la prueba y no se compara con estas cifras.
- Cada punto cubre 100 casos. No se publican los puntajes por caso ni la configuración del modelo interno. El proxy no es compute medido y no hay evaluación independiente.
Puedes alternar entre la curva y la diferencia exacta, mostrar los puntos intermedios y consultar cada valor. Los nueve puntajes y sus proxies de costo están publicados en los datos incrustados del gráfico. Dos de esas cifras, 0,594 y 0,875, también aparecen en el texto. Cada punto cubre 100 casos; la fuente declara harnesses de evaluación diferentes y no publica los puntajes individuales ni una varianza.
El eje horizontal usa un índice relativo en escala logarítmica: 1× para Astra al máximo y 3,376× para el punto de 0,875 del modelo interno. OpenAI aplica las tarifas de Astra para calcular el proxy del modelo interno. Ese índice no representa compute medido, dólares por tarea ni su precio comercial. Tampoco asignamos niveles de razonamiento donde la fuente no los identifica.
La diferencia de 0,281 y el aumento relativo de 47,3 % salen de restar y dividir esos dos promedios. Describen esta métrica y estos sistemas de evaluación; no aíslan el efecto del modelo frente al de su harness. Para proyectar otros benchmarks habría que declarar cómo se supone que se transfiere la ganancia entre tareas. Esa relación todavía no está publicada.
Corrección · 4 de noviembre: sustituimos las siete lecturas visuales iniciales por los nueve valores numéricos de la fuente. Incorporamos sus proxies de costo, los 100 casos por punto y la advertencia sobre los harnesses. Estos datos siguen perteneciendo a un modelo interno sin nombre.
GPT-6 Astra, Sol y GPT-6.2: la comparación
La comparación publicada con Sol 6.1 incluye seis pruebas con Astra y Sol a varios niveles de razonamiento. Tomamos cada par de esa misma publicación, con sus costos medios por tarea. La página original de Astra contiene evaluaciones anteriores y algunos valores distintos.
Benchmarks
GPT-6 Astra, Sol y GPT-6.2
Compara puntuación y coste medio por tarea en cinco niveles de esfuerzo.
- GPT-6 Astra
- GPT-6.1 Sol
- GPT-6.2
Puntuación · más es mejor
Coste medio por tarea (US$), escala logarítmica
DeepSWE · Resumen · esfuerzo Max
| Serie | Puntuación | Coste por tarea |
|---|---|---|
| GPT-6 Astra | 73,23 % | US$ 7,50 |
| GPT-6.1 Sol | 71,9 % | US$ 1,57 |
| GPT-6.2 | 80 % | US$ 25,31 |
Cómo calculamos las cifras
Ancla: en BenchCAD 2.0, un modelo interno de OpenAI sin nombre obtuvo 0,875 frente a 0,594 de Astra al máximo esfuerzo. Harnesses distintos, 100 casos por punto; el eje de costo de ese gráfico es un proxy con tarifas de Astra, no compute medido.
- Ventaja del ancla en escala logit: Δ = logit(0,875) − logit(0,594) ≈ 1,57.
- Para cada prueba y esfuerzo: p = logística(logit(puntuación de Astra) + k·Δ). k es la fracción de esa ventaja que se transfiere: 1 es toda, 0 nada y un valor negativo, un retroceso.
- 10.000 valores de k por supuesto con un generador pseudoaleatorio fijo (mulberry32, semilla 20261104): el resultado es reproducible. La distribución de k la elegimos nosotros; no es una prior calibrada.
- Se muestra el valor central de 10.000 cálculos bajo ese supuesto, redondeado a puntos porcentuales enteros. No es una probabilidad calibrada ni un ensayo de 100 casos.
- Aplicar esta diferencia a otras pruebas y a los cinco niveles de referencia de Astra es un supuesto elegido. El máximo esfuerzo solo está declarado para Astra; el nivel del modelo interno no se publica.
- Hipótesis de presupuesto: costo GPT-6.2 = costo de Astra por tarea × 3,376. El multiplicador procede del proxy relativo de BenchCAD 2.0; trasladarlo a otras pruebas y niveles es un supuesto de HeyMark, no una relación medida ni una tarifa comercial. No identifica al modelo interno como GPT-6.2.
- Los escenarios van en % enteros; los datos publicados conservan la precisión de la fuente. La tasa de errores factuales (menos es mejor) solo muestra datos reales.
La curva GPT-6.2 usa k uniforme en [−0,5; 1] y muestra la mediana calculada con 10.000 muestras y semilla fija.
Ver todas las cifras6 pruebas · 5 esfuerzos · puntuación y coste
| Esfuerzo | GPT-6 Astra | GPT-6.1 Sol | GPT-6.2 | |||
|---|---|---|---|---|---|---|
| Puntuación | Coste por tarea | Puntuación | Coste por tarea | Puntuación | Coste por tarea | |
| DeepSWE | ||||||
| Baja | 67,04 % | US$ 1,60 | 64,38 % | US$ 0,17 | 75 % | US$ 5,39 |
| Media | 72,79 % | US$ 3,08 | 73,01 % | US$ 0,42 | 80 % | US$ 10,38 |
| Alta | 73,23 % | US$ 3,92 | 75,22 % | US$ 0,65 | 80 % | US$ 13,25 |
| Muy alta | 74,12 % | US$ 4,43 | 71,9 % | US$ 0,79 | 81 % | US$ 14,95 |
| Max | 73,23 % | US$ 7,50 | 71,9 % | US$ 1,57 | 80 % | US$ 25,31 |
| GDP.pdf | ||||||
| Baja | 30,4 % | US$ 1,70 | 27 % | US$ 0,33 | 40 % | US$ 5,73 |
| Media | 30,4 % | US$ 1,72 | 30 % | US$ 0,34 | 40 % | US$ 5,81 |
| Alta | 31 % | US$ 1,79 | 32 % | US$ 0,35 | 40 % | US$ 6,06 |
| Muy alta | 32,2 % | US$ 1,91 | 31,8 % | US$ 0,37 | 42 % | US$ 6,46 |
| Max | 31 % | US$ 2,08 | 31 % | US$ 0,42 | 40 % | US$ 7,01 |
| AutomationBench | ||||||
| Baja | 30,3 % | US$ 1,08 | 24,7 % | US$ 0,16 | 39 % | US$ 3,65 |
| Media | 34,1 % | US$ 1,27 | 31,7 % | US$ 0,19 | 44 % | US$ 4,29 |
| Alta | 37,1 % | US$ 1,44 | 33,2 % | US$ 0,23 | 47 % | US$ 4,86 |
| Muy alta | 39 % | US$ 1,50 | 35,5 % | US$ 0,25 | 49 % | US$ 5,06 |
| Max | 41,4 % | US$ 1,73 | 36,1 % | US$ 0,30 | 51 % | US$ 5,84 |
| OSWorld 2.0, conjunto sin conexión | ||||||
| Baja | 62,17 % | US$ 2,72 | 58,96 % | US$ 0,42 | 71 % | US$ 9,17 |
| Media | 69,25 % | US$ 5,36 | 66,84 % | US$ 0,77 | 77 % | US$ 18,09 |
| Alta | 70,02 % | US$ 6,91 | 69,56 % | US$ 0,96 | 78 % | US$ 23,32 |
| Muy alta | 71,27 % | US$ 7,49 | 69,38 % | US$ 1,05 | 79 % | US$ 25,30 |
| Max | 73,49 % | US$ 9,44 | 71,42 % | US$ 1,27 | 81 % | US$ 31,85 |
| Terminal-Bench Science 0.1 | ||||||
| Baja | 55,43 % | US$ 11,41 | 43,71 % | US$ 1,79 | 65 % | US$ 38,51 |
| Media | 57,43 % | US$ 12,34 | 47,56 % | US$ 2,34 | 67 % | US$ 41,65 |
| Alta | 62 % | US$ 14,95 | 51,14 % | US$ 2,76 | 71 % | US$ 50,48 |
| Muy alta | 60,86 % | US$ 15,76 | 53,71 % | US$ 2,89 | 70 % | US$ 53,19 |
| Max | 68,1 % | US$ 23,80 | 57,02 % | US$ 5,47 | 76 % | US$ 80,34 |
| Tasa de errores factuales con prompts difíciles · Tasa de error (menos es mejor) | ||||||
| Baja | 6,26 % | US$ 0,24 | 7,72 % | US$ 0,05 | — | US$ 0,82 |
| Media | 4,41 % | US$ 0,31 | 6,29 % | US$ 0,06 | — | US$ 1,05 |
| Alta | 3,9 % | US$ 0,48 | 4,52 % | US$ 0,08 | — | US$ 1,61 |
| Muy alta | 3,99 % | US$ 0,60 | 4,12 % | US$ 0,10 | — | US$ 2,04 |
| Max | 3,91 % | US$ 0,79 | 4,61 % | US$ 0,13 | — | US$ 2,66 |
Las pistas de Bel, Betelgeuse y rc-ada
Abre cada pista para ver la publicación original, qué muestra y qué parte requiere una inferencia. Incluimos el relato que sostiene que todo fue un engaño: también tiene límites y merece el mismo examen.
Mapa de evidencia
Seis pistas y lo que cada una no prueba
Pistas fechadas y contraseñales, cada una con fecha, autor y fuente. Abre una para ver qué muestra y dónde termina.
Dato oficial · verificadoOpenAI muestra un modelo interno sin nombre en BenchCAD 2.0
- Qué muestra
- En su post del 3 de noviembre, OpenAI cita un puntaje medio de 0,875 para un modelo interno más nuevo, frente a 0,594 de GPT-6 Astra en su nivel máximo de razonamiento.
- Qué no prueba
- No lo llama GPT-6.2, Betelgeuse ni Bel, ni anuncia un lanzamiento. El gráfico cubre 100 casos por punto con harnesses diferentes. No publica los puntajes individuales, la configuración ni el precio comercial del modelo interno; no hay evaluación independiente.
- Lectura HeyMark
- Es el único benchmark de esta lista con fuente primaria. Sus datos no identifican al modelo interno como GPT-6.2.
- Fuentes
Captura sin autenticarUn tracker de terceros muestra «gpt-6.2-betelgeuse»
- Qué muestra
- Una captura de un bot de Discord llamado «Internal Tracker» con el string gpt-6.2-betelgeuse marcado como interno. Sumó cerca de 568 mil vistas.
- Qué no prueba
- El tracker no es de OpenAI y la captura no tiene una procedencia verificable: no hay endpoint, modelo que se pueda llamar ni respuesta.
- Lectura HeyMark
- Prueba que el nombre circula, no que exista dentro de OpenAI.
- Fuentes
AmplificaciónLa cuenta que lo amplificó empieza con «Cant confirm»
- Qué muestra
- Cita la captura del tracker y la presenta como la llegada de un «GPT-6.2 bel». Sumó unas 130 mil vistas.
- Qué no prueba
- El propio autor dice que no puede confirmarlo. Unir «Bel» con «Betelgeuse» es su interpretación. El «Bel» original viene de una cuenta anónima que en agosto habló de un pretrain de más de 10T parámetros; nada de eso está confirmado.
- Lectura HeyMark
- Creció el alcance, no la evidencia.
- Fuentes
Contraseñal en disputaUn relato sostiene que Betelgeuse fue un engaño
- Qué muestra
- TokenGremlin afirmó que el nombre se inventó para medir qué tan fácil se difunden filtraciones sin verificar. El relato llegó a Reddit el 1 de noviembre.
- Qué no prueba
- Se apoya en mensajes de terceros que tampoco tienen fuente. No demuestra que el nombre sea falso, igual que la captura no demuestra que sea real.
- Lectura HeyMark
- Lo tratamos como relato en disputa, no como desmentido.
Empleado · ambiguoLos mensajes crípticos de Tibo
- Qué muestra
- Tibo publicó «Day 28/ Banked 2/2» dentro de su reto diario y, después, «Le GPT Fat» y «ChatBLT». Parte de la comunidad los leyó como pistas de un modelo nuevo.
- Qué no prueba
- Ninguno menciona nombre, tamaño ni fecha. El reto prometía una entrega o un reinicio de límites cada día, no un modelo. Leer «fat» como «pretrain grande» es interpretación.
- Lectura HeyMark
- Señal real de una persona real, sin contenido verificable.
Observación múltipleDos IDs aparecen y desaparecen de la lista de la API
- Qué muestra
- Varios autores reportaron ver rc-ada-or-vm y rc-ada-sh-vm en la lista de modelos de la API.
- Qué no prueba
- Ningún ID contiene «6.2» ni «betelgeuse». Leer «rc» como release candidate y «vm» como sandbox son conjeturas de quienes los vieron.
- Lectura HeyMark
- Los reportes coinciden en los identificadores. Su función y su relación con un modelo concreto siguen sin confirmar.
Corte editorial: 4 nov 2026, 12:54 (Santiago). Al corte, el catálogo y el changelog de la API de OpenAI no listaban GPT-6.2, betelgeuse ni Bel. No asignamos porcentajes de confianza: cada pista dice qué muestra y dónde se detiene.
La cronología importa. El rumor de “Bel” de agosto precede al gráfico de noviembre. Después aparece el tracker de terceros del 29 de octubre. Más tarde llegan los IDs rc-ada-or-vm y rc-ada-sh-vm, junto con el nuevo benchmark. Que esas conversaciones coincidan esta semana no demuestra que hablen del mismo modelo.
Bel también se leyó como Bellatrix
El nombre tiene otra lectura que apareció antes de la captura de Betelgeuse. El 25 de agosto, @CiprianiMacovei respondió a ChrisGPT con «Bel from Bellatrix». Es una interpretación de un usuario. La publicación no confirma un nombre de OpenAI ni su relación con GPT-6.2.
La guía astronómica de ESA describe Bellatrix como azulada, de tipo B2 III, y a Betelgeuse como roja, de tipo M2 Iab. El diagrama de ESO también las sitúa en regiones muy distintas de luminosidad y tamaño. Ambas son mayores que el Sol, con características físicas diferentes. En nuestro cielo marcan los dos hombros de Orión; compartir constelación describe su posición aparente y no una distancia física corta entre ellas.
La portada recorre las dos interpretaciones de Bel: naranja para Betelgeuse y azul para Bellatrix. El tamaño visual es ilustrativo y no usa una escala astronómica. La posibilidad de que OpenAI elija uno de esos nombres, o presente más de un modelo, sigue abierta. Tampoco hay evidencia para asignarles perfiles, precios o puntajes diferentes. Ni el apodo ni el color permiten anticipar un lanzamiento.
Tres maneras de conectar las señales
La hipótesis de una nueva generación. Parte de la comunidad interpreta Bel como un entrenamiento mayor, toma la captura de Betelgeuse como nombre y ve el modelo interno como su primer resultado público. La historia encaja, pero necesita dos puentes: demostrar la procedencia de la captura y vincular ese identificador con el modelo evaluado. Ninguna de las fuentes consultadas establece ambos.
La hipótesis de investigación o pruebas de producto. Un modelo interno puede servir para investigación o para una experiencia especializada. Dos identificadores observados en una API pueden representar experimentos distintos. Esta lectura explica las señales sin asumir que habrá un lanzamiento general inmediato. También sigue siendo una hipótesis.
La hipótesis de un rumor que se alimenta a sí mismo. Una captura se amplifica, se le añaden parámetros y precio, y cada repetición empieza a parecer otra confirmación. El contra-relato de TokenGremlin sostiene que el nombre fue inventado. Su explicación depende de mensajes privados que no podemos comprobar. Sirve para cuestionar la historia, no para darla por resuelta.
Los números que todavía no tienen respaldo
Un post del 30 de octubre atribuye al supuesto modelo 12T parámetros, 72 puntos en Artificial Analysis y un precio de US$20/US$100 por millón de tokens. La fuente invocada es un insider sin nombre. Estas cifras quedan como afirmaciones de esa cuenta. No encontramos una ficha oficial de Betelgeuse ni un resultado verificable que permita usarlas como especificaciones.
Tampoco conviene comparar el resultado de BenchCAD 2.0 con el 95,9 % de BenchCAD de la presentación de Astra. Son versiones diferentes. Un gráfico atractivo puede ocultar esa diferencia con facilidad; aquí mantenemos la versión junto a cada número.
Qué cambiaría el estado de la historia
Una entrada en el changelog, una ficha de modelo y un anuncio que conecte el nombre con sus capacidades cambiarían la situación. Para evaluar rendimiento, harían falta tareas, versión del benchmark, configuración, herramientas y costo. Una captura del selector o la respuesta de un modelo diciendo cómo se llama no completan esa comprobación.
Si ya usas los modelos actuales, puedes consultar nuestras noticias de GPT-6.1 Terra y Astra Pro. Sus pruebas y condiciones corresponden a productos identificados. Esta edición conserva las teorías como teorías y deja las fuentes a un clic, para que puedas seguir el rastro sin convertir cada teaser en una fecha de lanzamiento.
Fuente
Planifica el próximo post en HeyMark.
Guarda la idea, revisa el texto con tu equipo y mira cómo le fue después en las cuentas que conectaste.