Noticias OpenAI
OpenAI DevDay 2026: dots, GPT-6.1 Sol y el nuevo Space
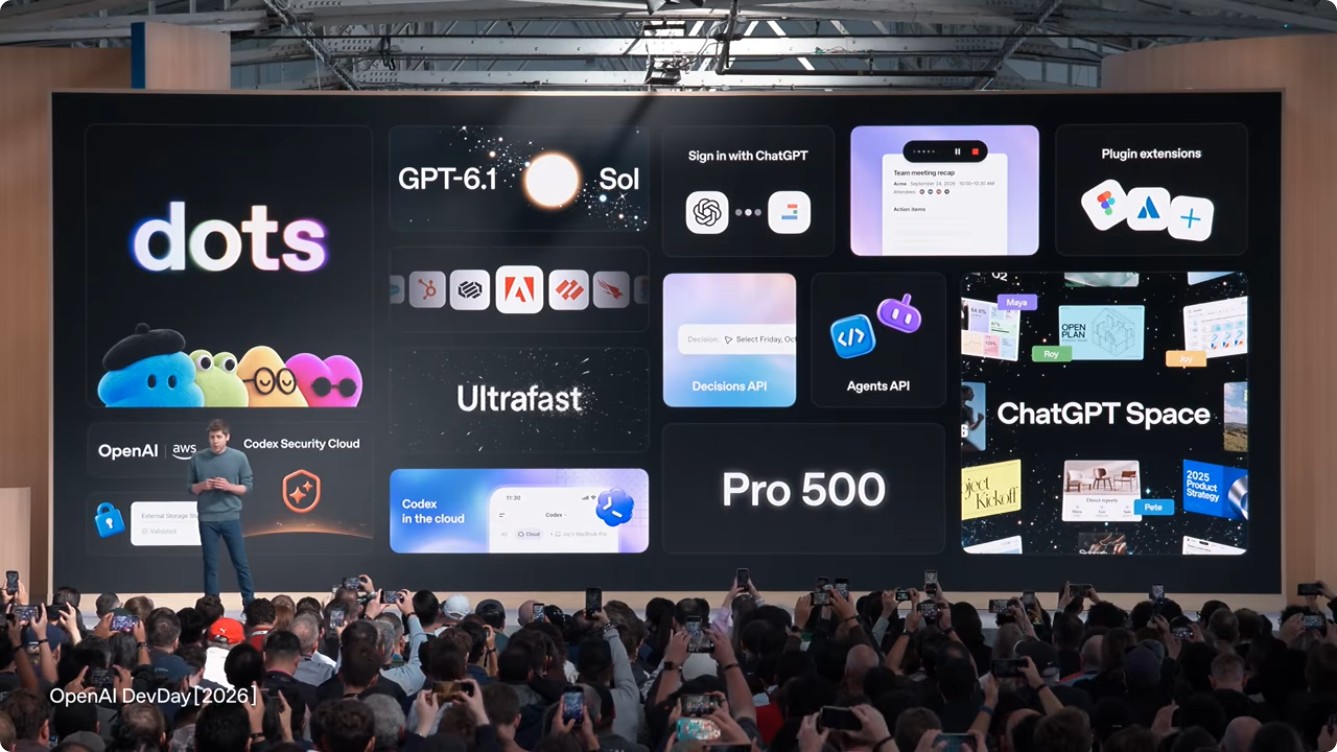
OpenAI presenta agentes que trabajan de forma continua, un Sol más capaz y páginas compartidas con IA. Qué cambia, cuánto cuesta la API y qué puedes usar ya.
OpenAI presentó dots, GPT-6.1 Sol y ChatGPT Space este 29 de septiembre en DevDay 2026. La keynote combinó agentes que mantienen tareas en marcha, colaboración dentro de ChatGPT y novedades para quienes construyen aplicaciones.
Las caras del teaser que analizamos ayer ya tienen un anuncio que las acompaña: dots. Las demos mostraron cómo delegar trabajo y revisarlo después. Algunas funciones empiezan a desplegarse; otras siguen en preview o llegarán más adelante.
Disponibilidad
dotsDespliegue gradual
Agentes con contexto persistente y ordenador en la nube. Pro y Business Premium en mercados elegibles; beta empresarial con activación del administrador.
Consultar disponibilidad ↗GPT-6.1 SolDisponible
En la API, Codex y ChatGPT Work. Todavía no en Chat. La velocidad Ultrafast para Sol llegará después.
Consultar disponibilidad ↗Space + PagesDisponible según plan
Páginas compartidas con personas y agentes. Creación y edición en web y escritorio; en móvil puedes buscar, leer y compartir. Diapositivas colaborativas: próximamente.
Consultar disponibilidad ↗Qué son los dots de OpenAI
Los dots usan GPT-6 Astra, conservan contexto y trabajan en su propio ordenador en la nube. Puedes seguir una tarea desde ChatGPT, Slack o Teams. OpenAI plantea delegarles responsabilidades continuas, como revisar información y preparar trabajo para aprobación.
El primer dot está incluido en los planes elegibles, con una asignación de trabajo. Las tareas que encarga a Codex o Work consumen sus límites habituales. Conviene revisar las aplicaciones conectadas y las reglas de aprobación antes de delegar.
GPT-6.1 Sol: precio de API y rendimiento
OpenAI presenta GPT-6.1 Sol como una opción cercana a Astra en sus evaluaciones, con menores precios por token. Esa comparación depende de la tarea; todavía falta probarlo con nuestros propios materiales.
Benchmarks de Sol 6.1 frente a Sol, Astra y Opus
Elige una prueba y un nivel de razonamiento. Cada barra muestra la puntuación; debajo de la cifra aparece el coste medio por tarea en esa misma evaluación. Low, Medium, High, Xhigh y Max son configuraciones de razonamiento, no planes de pago.
DeepSWE
DeepSWE 1.1 · tareas de ingeniería de software en repositorios reales.
- GPT-6.1 Sol
- 64,38%US$0,17 / tarea
- GPT-6 Sol
- 37,17%US$0,16 / tarea
- GPT-6 Astra
- 67,04%US$1,60 / tarea
DeepSWE
DeepSWE 1.1 · tareas de ingeniería de software en repositorios reales.
- GPT-6.1 Sol
- 73,01%US$0,42 / tarea
- GPT-6 Sol
- 56,64%US$0,38 / tarea
- GPT-6 Astra
- 72,79%US$3,08 / tarea
DeepSWE
DeepSWE 1.1 · tareas de ingeniería de software en repositorios reales.
- GPT-6.1 Sol
- 75,22%US$0,65 / tarea
- GPT-6 Sol
- 65,27%US$0,64 / tarea
- GPT-6 Astra
- 73,23%US$3,92 / tarea
DeepSWE
DeepSWE 1.1 · tareas de ingeniería de software en repositorios reales.
- GPT-6.1 Sol
- 71,90%US$0,79 / tarea
- GPT-6 Sol
- 66,59%US$1,00 / tarea
- GPT-6 Astra
- 74,12%US$4,43 / tarea
DeepSWE
DeepSWE 1.1 · tareas de ingeniería de software en repositorios reales.
- GPT-6.1 Sol
- 71,90%US$1,57 / tarea
- GPT-6 Sol
- 68,81%US$2,74 / tarea
- GPT-6 Astra
- 73,23%US$7,50 / tarea
AutomationBench
AutomationBench 1.0.6 · flujos de trabajo con herramientas. Opus incluye modelos de respaldo.
- GPT-6.1 Sol
- 24,70%US$0,16 / tarea
- GPT-6 Sol
- 21,16%US$0,19 / tarea
- GPT-6 Astra
- 30,30%US$1,08 / tarea
- Opus 5.5 + respaldo
- 24,20%US$0,51 / tarea
AutomationBench
AutomationBench 1.0.6 · flujos de trabajo con herramientas. Opus incluye modelos de respaldo.
- GPT-6.1 Sol
- 31,70%US$0,19 / tarea
- GPT-6 Sol
- 26,94%US$0,21 / tarea
- GPT-6 Astra
- 34,10%US$1,27 / tarea
- Opus 5.5 + respaldo
- 29,53%US$0,65 / tarea
AutomationBench
AutomationBench 1.0.6 · flujos de trabajo con herramientas. Opus incluye modelos de respaldo.
- GPT-6.1 Sol
- 33,20%US$0,23 / tarea
- GPT-6 Sol
- 31,20%US$0,24 / tarea
- GPT-6 Astra
- 37,10%US$1,44 / tarea
- Opus 5.5 + respaldo
- 33,03%US$0,71 / tarea
AutomationBench
AutomationBench 1.0.6 · flujos de trabajo con herramientas. Opus incluye modelos de respaldo.
- GPT-6.1 Sol
- 35,50%US$0,25 / tarea
- GPT-6 Sol
- 33,18%US$0,27 / tarea
- GPT-6 Astra
- 39,00%US$1,50 / tarea
- Opus 5.5 + respaldo
- 35,77%US$0,89 / tarea
AutomationBench
AutomationBench 1.0.6 · flujos de trabajo con herramientas. Opus incluye modelos de respaldo.
- GPT-6.1 Sol
- 36,10%US$0,30 / tarea
- GPT-6 Sol
- 31,96%US$0,34 / tarea
- GPT-6 Astra
- 41,40%US$1,73 / tarea
- Opus 5.5 + respaldo
- 42,47%US$1,44 / tarea
OSWorld 2.0, offline set
OSWorld 2.0 · recompensa parcial en el conjunto offline v2026.08.08; no equivale a porcentaje de tareas completadas.
- GPT-6.1 Sol
- 58,96%US$0,42 / tarea
- GPT-6 Sol
- 43,90%US$1,01 / tarea
- GPT-6 Astra
- 62,17%US$2,72 / tarea
OSWorld 2.0, offline set
OSWorld 2.0 · recompensa parcial en el conjunto offline v2026.08.08; no equivale a porcentaje de tareas completadas.
- GPT-6.1 Sol
- 66,84%US$0,77 / tarea
- GPT-6 Sol
- 54,00%US$1,38 / tarea
- GPT-6 Astra
- 69,25%US$5,36 / tarea
OSWorld 2.0, offline set
OSWorld 2.0 · recompensa parcial en el conjunto offline v2026.08.08; no equivale a porcentaje de tareas completadas.
- GPT-6.1 Sol
- 69,56%US$0,96 / tarea
- GPT-6 Sol
- 58,29%US$1,71 / tarea
- GPT-6 Astra
- 70,02%US$6,91 / tarea
OSWorld 2.0, offline set
OSWorld 2.0 · recompensa parcial en el conjunto offline v2026.08.08; no equivale a porcentaje de tareas completadas.
- GPT-6.1 Sol
- 69,38%US$1,05 / tarea
- GPT-6 Sol
- 60,54%US$2,30 / tarea
- GPT-6 Astra
- 71,27%US$7,49 / tarea
OSWorld 2.0, offline set
OSWorld 2.0 · recompensa parcial en el conjunto offline v2026.08.08; no equivale a porcentaje de tareas completadas.
- GPT-6.1 Sol
- 71,42%US$1,27 / tarea
- GPT-6 Sol
- 64,43%US$3,37 / tarea
- GPT-6 Astra
- 73,49%US$9,44 / tarea
Terminal-Bench Science 0.1
Terminal-Bench Science 0.1 · análisis de datos, simulaciones y otras tareas científicas. Opus solo tiene un resultado Max en este gráfico y usa modelos de respaldo.
- GPT-6.1 Sol
- 43,71%US$1,79 / tarea
- GPT-6 Sol
- 9,17%US$3,00 / tarea
- GPT-6 Astra
- 55,43%US$11,41 / tarea
Terminal-Bench Science 0.1
Terminal-Bench Science 0.1 · análisis de datos, simulaciones y otras tareas científicas. Opus solo tiene un resultado Max en este gráfico y usa modelos de respaldo.
- GPT-6.1 Sol
- 47,56%US$2,34 / tarea
- GPT-6 Sol
- 14,49%US$4,41 / tarea
- GPT-6 Astra
- 57,43%US$12,34 / tarea
Terminal-Bench Science 0.1
Terminal-Bench Science 0.1 · análisis de datos, simulaciones y otras tareas científicas. Opus solo tiene un resultado Max en este gráfico y usa modelos de respaldo.
- GPT-6.1 Sol
- 51,14%US$2,76 / tarea
- GPT-6 Sol
- 14,61%US$4,63 / tarea
- GPT-6 Astra
- 62,00%US$14,95 / tarea
Terminal-Bench Science 0.1
Terminal-Bench Science 0.1 · análisis de datos, simulaciones y otras tareas científicas. Opus solo tiene un resultado Max en este gráfico y usa modelos de respaldo.
- GPT-6.1 Sol
- 53,71%US$2,89 / tarea
- GPT-6 Sol
- 25,29%US$6,77 / tarea
- GPT-6 Astra
- 60,86%US$15,76 / tarea
Terminal-Bench Science 0.1
Terminal-Bench Science 0.1 · análisis de datos, simulaciones y otras tareas científicas. Opus solo tiene un resultado Max en este gráfico y usa modelos de respaldo.
- GPT-6.1 Sol
- 57,02%US$5,47 / tarea
- GPT-6 Sol
- 27,59%US$12,18 / tarea
- GPT-6 Astra
- 68,10%US$23,80 / tarea
- Opus 5.5 + respaldo
- 63,33%US$23,21 / tarea
Mayor puntuación es mejor. Coste medio de esta evaluación; no es un precio fijo por tarea. Los resultados publicados por OpenAI dependen de herramientas y configuración. Datos y metodología ↗
Tres comparaciones ayudan a interpretar los datos:
- Código, High: Sol 6.1 obtiene 75,22% en DeepSWE, frente a 73,23% de Astra. El coste medio es US$0,65 y US$3,92, respectivamente.
- Automatización, Medium: Sol 6.1 alcanza 31,70%; Opus 5.5 con modelos de respaldo, 29,53%. Los costes son US$0,19 y US$0,65 por tarea.
- Ciencia, Max: Astra conserva una ventaja: 68,10% frente a 57,02% de Sol 6.1. Sol cuesta US$5,47 por tarea; Astra, US$23,80.
En estos resultados, subir el razonamiento no mejora siempre la puntuación. Tampoco conviene trasladar el coste de una prueba de programación a una tarea de marketing: cambian las herramientas, los tokens y el criterio de éxito.
Cuánto cuesta usar la API
| GPT-6.1 Sol | US$ |
|---|---|
| Entrada | 2.00 |
| Entrada en caché | 0.10 |
| Salida | 10.00 |
Tarifas oficiales. El identificador es gpt-6.1-sol. Como ejemplo calculado, 10.000 tokens de entrada y 2.000 de salida cuestan US$0,04, sin herramientas ni caché. Un proceso con varias llamadas acumula consumo.
Space y Pages: revisar el trabajo con tu equipo
ChatGPT Space permite trabajar en páginas compartidas, comentar y pedir cambios a ChatGPT o a un dot. Está disponible en Pro, Business y Enterprise. En móvil, el lanzamiento permite consultar y compartir; la edición llegará después.
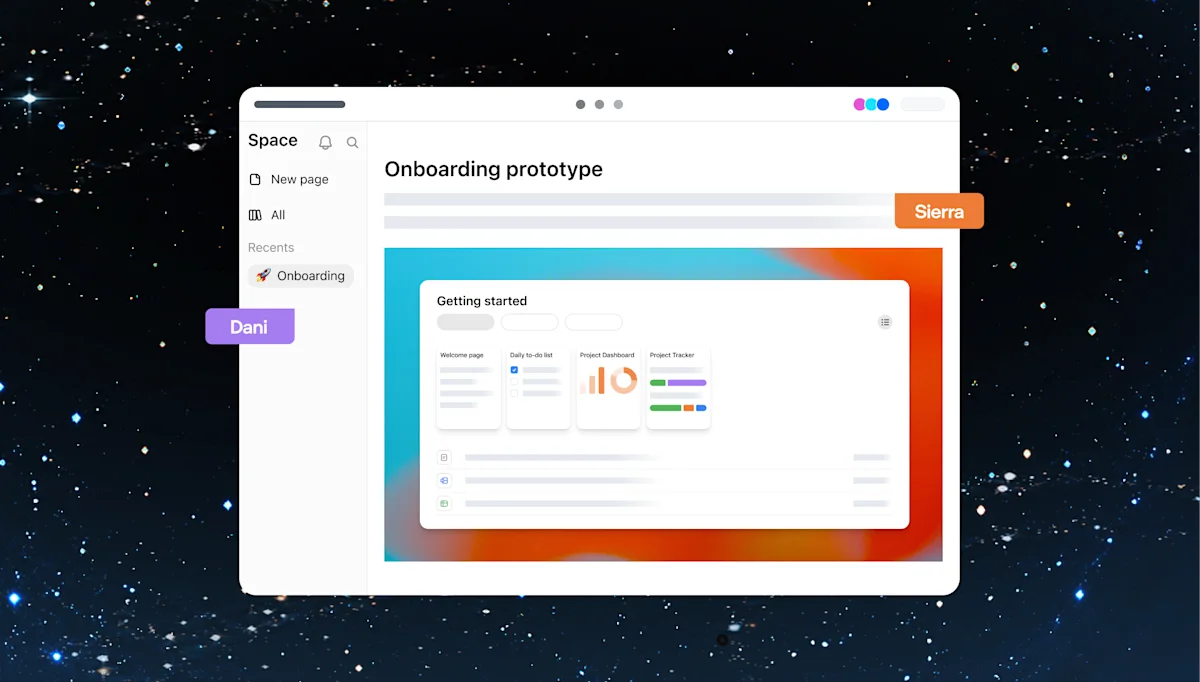
Para un equipo de contenido, proponemos probarlo con un brief real: reunir referencias, pedir una propuesta y revisar los cambios en la página. La prueba útil será comprobar si conserva las decisiones de marca y distingue los datos de las suposiciones.
Plugins y uso de tu plan en otras aplicaciones
Las extensiones de plugins permiten añadir paneles y editores dentro de ChatGPT. En el escenario aparecieron ejemplos de diseño y colaboración, incluido Adobe.
Con Sign in with ChatGPT, los usuarios Plus y Pro pueden autorizar que aplicaciones participantes consuman su asignación. Puedes fijar un límite semanal por app. La aplicación puede cobrar aparte por sus propios servicios.
Más anuncios de la keynote
- Ultrafast: OpenAI anuncia hasta 300 tokens por segundo en Codex. La velocidad de generación no mide por sí sola cuánto tarda una tarea completa.
- Codex Security Cloud: revisa repositorios, investiga hallazgos y prepara correcciones en la nube.
- Decisions API: preview limitada para elegir entre respuestas predefinidas con Luna.
- Agents API y Bedrock: uso del ordenador y nuevas opciones para ejecutar agentes.
- Pro 500, Private Intelligence y Marketplace: más capacidad de uso y novedades empresariales.
El recap oficial detalla planes y disponibilidad. En la keynote, la demo de voz tuvo dificultades y el presentador continuó desde la terminal. Es un recordatorio práctico: antes de incorporar un flujo al trabajo diario, hay que probarlo con tareas propias.
En marketing empezaría por una entrega pequeña y verificable: un informe con sus fuentes, un brief revisado o una propuesta con cambios trazables. Para preparar los datos de esa prueba, nuestra guía de análisis de redes con datos reales explica cómo comprobar las cifras. La compatibilidad específica de los nuevos dots con HeyMark sigue pendiente de prueba.
Fuente
Planifica el próximo post en HeyMark.
Guarda la idea, revisa el texto con tu equipo y mira cómo le fue después en las cuentas que conectaste.